以 AI 的速度,达到学术级的严谨
Skimle 由学者为学者打造。联合创始人 Henri Schildt 教授在定性研究领域有数十年经验,论文发表于《Academy of Management Journal》《Organization Science》等顶级管理学期刊。他受够了 NVivo 和 MAXQDA 迟缓笨拙的流程,也担忧 ChatGPT 被用于缺乏透明度和完整性的分析。于是他打造了 Skimle:一个复现严谨、透明的定性方法论,同时以 AI 为内核的平台。
人工完成访谈的初始编码可能要花上数周。Skimle 在不牺牲方法严谨性的前提下完成这项工作,还常常捕捉到人眼会漏掉的引语。每个主题都关联到经核验的原文引语。完整的审计链足以让同行评议信服。
教学材料 →严谨的分析,让您专注于自己的理论贡献
Skimle 的方法借鉴了扎根理论(Glaser & Strauss;Strauss & Corbin)与 Gioia 方法。它产出同行评议所要求的系统、透明的分析,却不必耗费数周做机械编码——那些时间本该花在理论上。它支持 100 多种语言,每个项目最多可处理 1,000 份文档。
- 自动化的初始编码——每一条引语都关联到它的类别
- 完整的双向审计链,服务于同行评议与方法透明
- 编码手册由您掌控——自由合并、拆分、重命名并重组类别
- 支持 100 多种语言,无需翻译
- 可处理访谈、音视频、书籍、文档与档案材料
- 提供 Skimle Academic 折扣方案
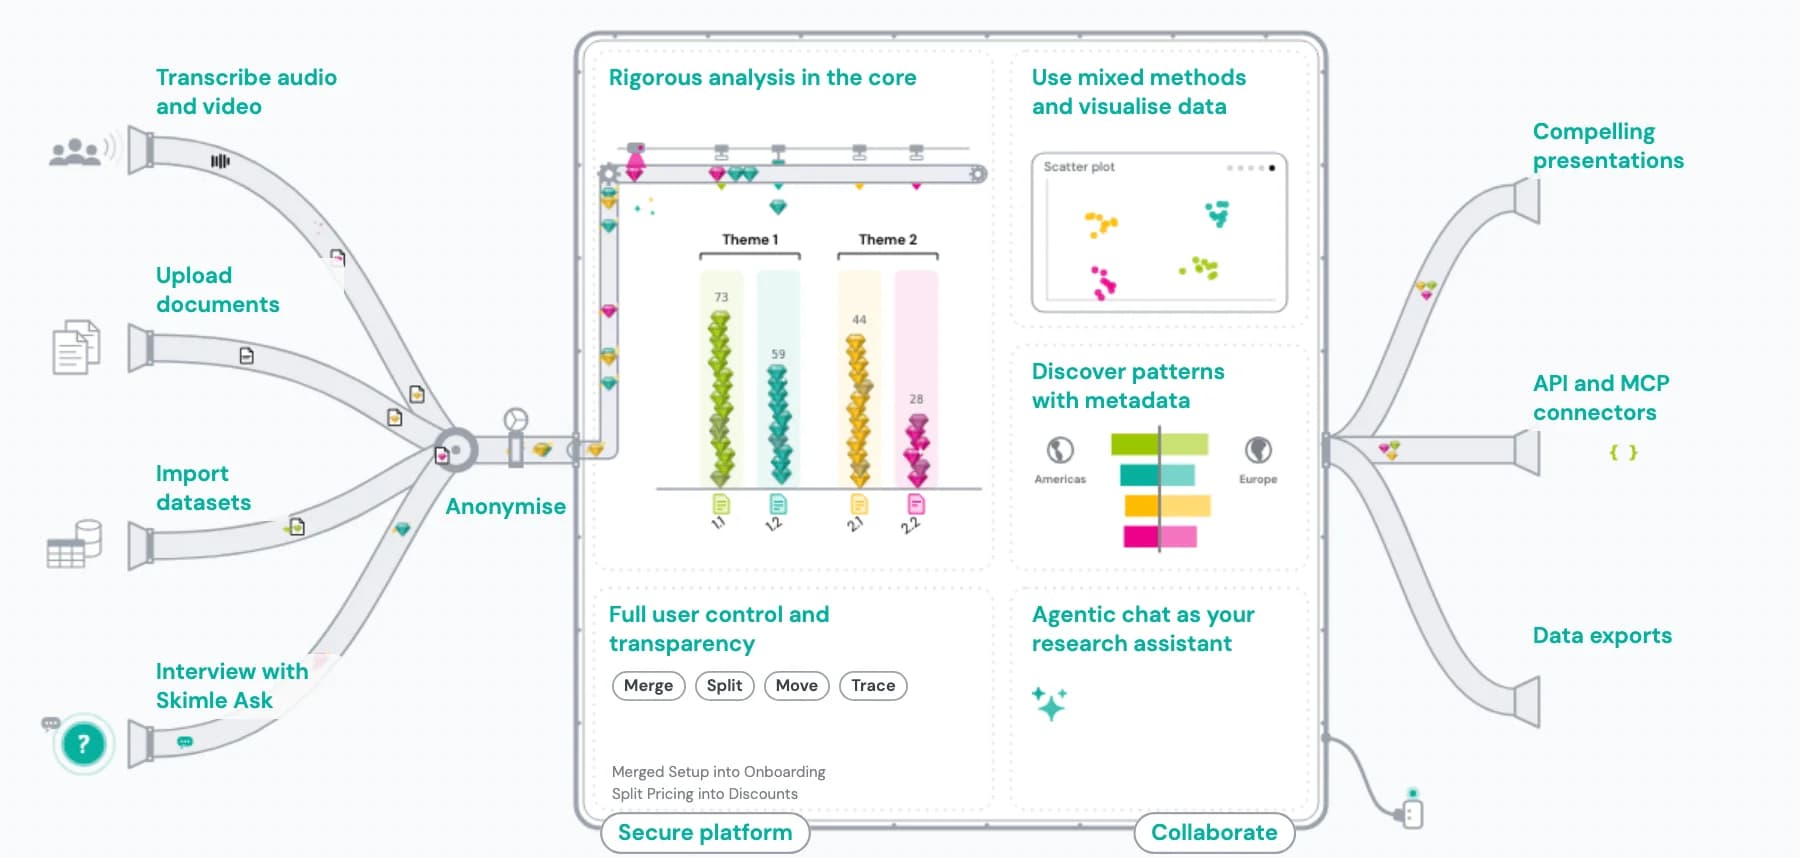
转写并匿名化访谈
通过第三方服务把田野录音变成可用数据,既慢又贵,而得到的转写稿里带着姓名、单位与地点,在您分享、归档或引用之前就已产生 GDPR 与伦理方面的义务。Skimle 在其安全的欧盟托管环境中完成音视频转写,再以研究级的假名化做匿名处理——当天您就能拿到一份合规、可直接编码的转写稿,数据始终不离开符合 GDPR 的基础设施。
运作方式
- 1. 上传音频、视频或文本
直接上传 MP3、M4A、WAV、MP4、MOV、PDF 或 Word 文件。无需外部转写服务,并原生支持 100 多种语言。
- 2. 转写并标注说话人
Skimle 会转写录音、识别说话人切换,并能应对口音和参差不齐的音质。在分析开始前,您可以复核并修正结果。
- 3. 自动检测标识信息
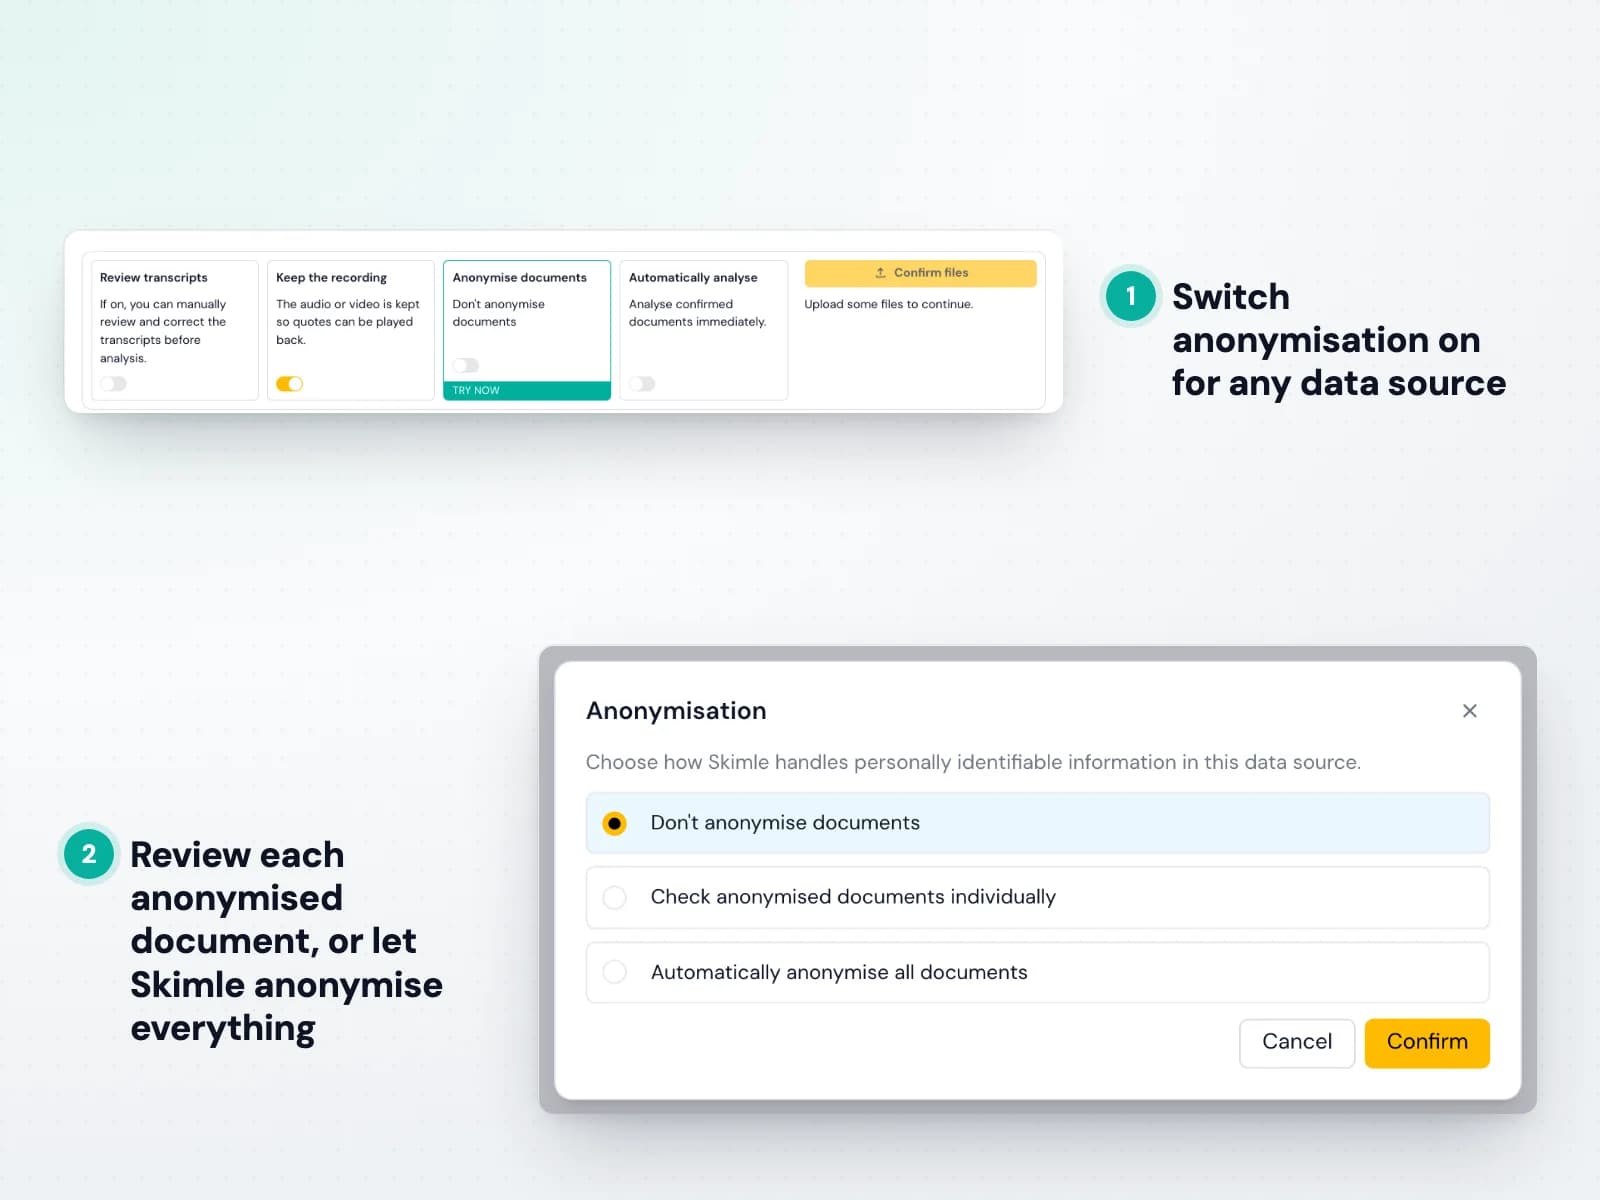
Skimle Anonymise 会在所有文档中标记六类标识信息——姓名、职务与角色、地点、机构、日期及其他——并保持跨文件一致,同一个人始终使用同一个化名。
- 4. 选择匿名化级别
可选择轻度假名化、强假名化,或销毁密钥的 HIPAA 级匿名化。每一类都可单独调节,还能用日常语言添加自定义规则。
- 5. 连同审计文档一并导出
为伦理委员会导出 PDF 审计报告和 Excel 对照表,再把清理后的转写稿直接送入 Skimle 的工作流。源音频随后会被安全删除。

开展 AI 辅助的访谈定性分析
基于 40 场以上访谈的研究本应产出丰富的理论贡献(例如您的博士论文),但人工编码——标注、整理、重新编码、维护清单——会吃掉大部分可用时间,而且仍可能漏掉重要规律。Skimle 系统性地阅读每一场访谈,交给您一份带原文引语的结构化主题层级,让您把时间用在只有您才能完成的理论诠释上。
运作方式
- 1. 上传您的转写稿
把 PDF、Word 或纯文本格式的访谈转写稿拖进来。Skimle 接受任意格式的文档,并原生支持 100 多种语言。
- 2. 描述您的研究问题
设定您的分析焦点,可宽可窄。Skimle 会围绕您在理论上想弄清楚的问题来组织初始编码。
- 3. 复核初始的编码结构
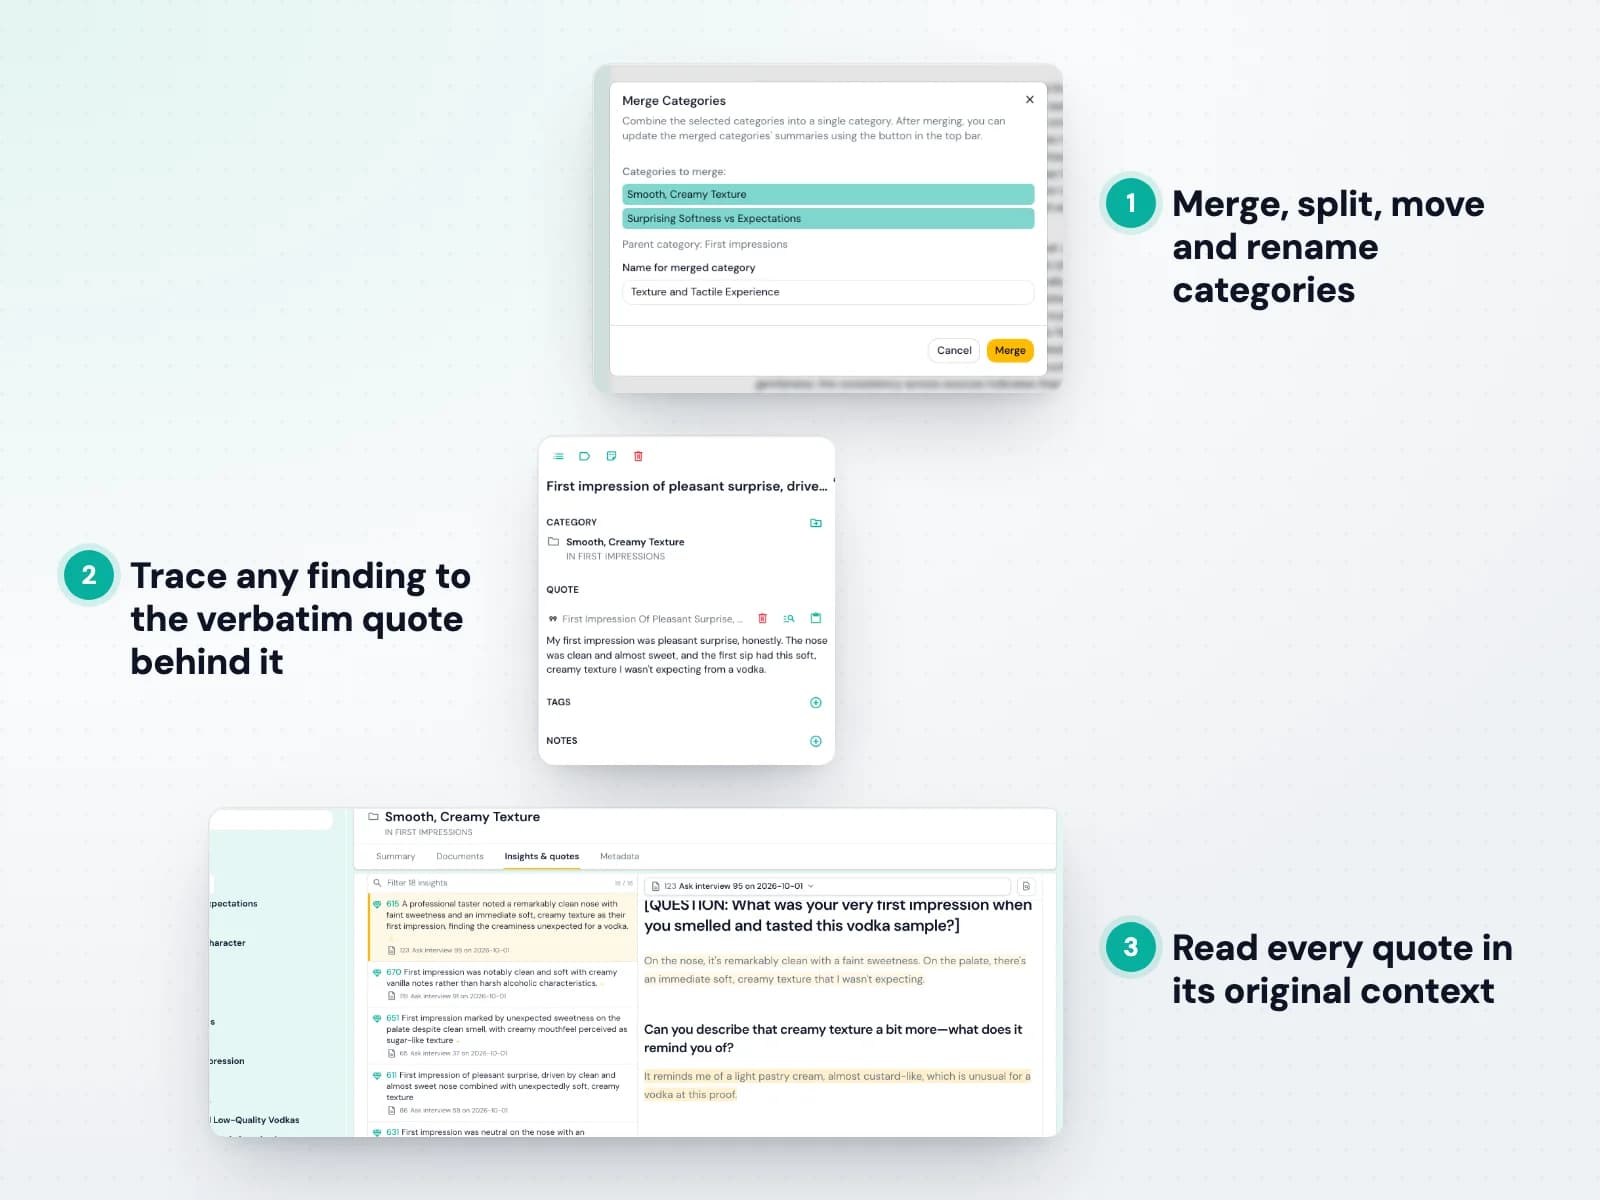
Skimle 会生成一套主题层级,每个主题都关联到源转写稿中的原文引语。没有任何内容是编造的。每一个编码都能追溯到文本。
- 4. 按您的理论框架精细调整
随着理论模型逐渐成形,合并、拆分、重命名并重组类别。双向透明让您随时都能核实:是哪些引语支撑了哪些编码。
- 5. 为方法附录导出材料
把您的编码手册与支撑引语导出为文本,或导出为开源的 REFI-QDA(.qdpx)格式——NVivo、Atlas.TI、MAXQDA 等传统 CAQDAS 程序都支持。


在样本中开展混合方法分析
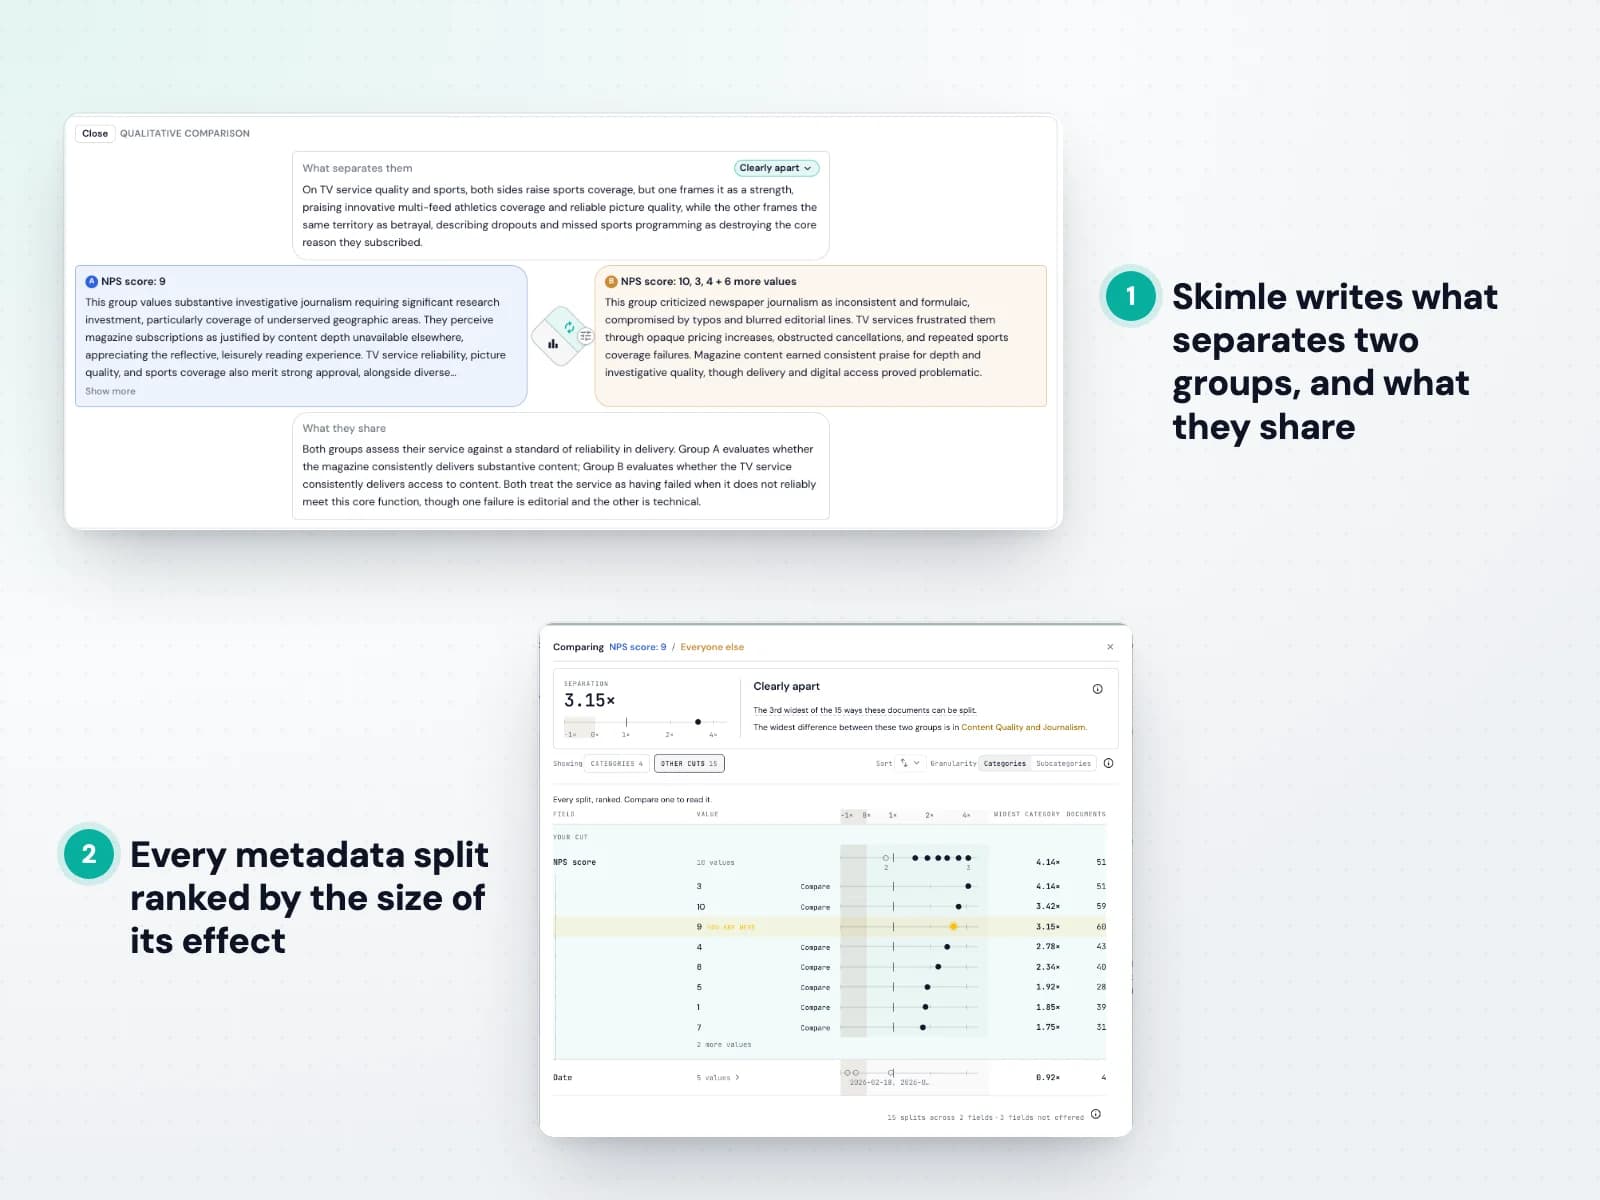
当您能展示定性结论在样本内如何随队列、角色、性别、地点或实验条件而变化时,它的分量会更重。手工把主题与参与者属性交叉制表既繁琐又容易出错。Skimle 为每份文档附上元数据,并允许您按任意变量切分同一套主题结构,让您在丰富的原文引语与量化规律之间自由往返,无需舍弃任何一种方法。
运作方式
- 1. 为文档附加元数据
为每份转写稿标注对您的研究设计重要的变量——队列、角色、性别、地点、调查轮次或实验条件——可手动录入,也可从 CSV 列导入。
- 2. 运行定性分析
Skimle 会在整个语料上构建一套统一的主题层级,因此所有参与者都依据同一结构被编码。
- 3. 按变量切分主题
查看每个主题在不同群体间如何变化,判断某个规律是普遍存在,还是只属于某一队列。
- 4. 量化普遍程度
查看主题的频次与分布,据此报告某个编码在各细分群体中的普遍程度,而每一个计数都能追溯到产生它的引语。
- 5. 导出表格与引语
把交叉表与支撑引语导出为 Excel 或 Word,用于论文的混合方法部分。
常见问题
- 我可以在研究中引用 Skimle 吗?
- 可以。在方法章节中把它描述为「AI 辅助的定性编码软件」,就像您引用 NVivo 或 MAXQDA 一样。我们有一篇方法学论文正在同行评议中,届时会提供正式引用格式;在此之前,如有需要我们可以提供建议表述。
- 同行评议会接受 AI 辅助的分析吗?
- 越来越多的情况下可以,只要文档记录得当。Skimle 的审计链提供了评审者期待的东西:一个有据可查、系统化的编码过程,每个主题都能追溯到具体引语,方法章节因此几乎可以自动成文。
- Skimle 与 NVivo 或 MAXQDA 相比如何?
- NVivo 和 MAXQDA 适合有数周时间做分析、并拥有机构授权的研究者。Skimle 把机械编码阶段自动化——从数周缩短到数小时——同时保持同样系统、透明的方法论,学习曲线只需几分钟。许多研究者两者并用:Skimle 做第一遍编码,NVivo 做混合方法整合。
- Skimle 适用于扎根理论吗?
- 适用。Skimle 支持归纳式编码,主题从数据中生成,而非事先设定。您可以从宽泛的焦点入手,让类别结构在反复迭代中逐渐成形——这与扎根理论中的开放式编码高度契合。
- 我可以做混合方法分析吗?
- 可以。为每份文档附加元数据变量——队列、角色、性别、地点、实验条件——并按其中任意一项切分主题结构。您会得到按群体划分的主题频次与分布,每一项都能追溯到原文引语,可直接用于论文的混合方法部分。
- 我的研究数据安全吗?
- 您的转写稿在欧盟境内的基础设施上处理,绝不会用于训练 AI 模型。我们为机构的伦理审查要求提供数据处理协议,也能满足大多数 IT 安全需求。如有具体要求,欢迎与我们联系。
- 可以获得学术折扣吗?
- 可以。持有有效机构邮箱和所属院系页面的学者,可以购买折扣版 Skimle Academic 套餐。如果研究小组或实验室需要团队访问权限,请联系我们了解机构授权。
由专业人士打造,服务专业人士
Skimle 拥有超过 1,500 名活跃用户,覆盖 50 多所大学、政府机构、代理机构和企业。所有数据均存储于 EU 境内,并严格依照我们的 GDPR 政策 与 服务条款.
想了解更多?欢迎浏览我们的 Signal & Noise 博客、我们的 常见问题,以及按行业划分的应用场景。我们也很乐意为您演示产品,或一起探讨 Skimle 如何契合您的需要。 了解 Skimle 背后的公司